ゲームなんとけ

ゲームとかパソコンとかのブログ

カテゴリ:パソコン一般 > AI

過去に作ったあいうぉPVなんかはChatGPTにつくらせてたんですけど、ちょっとえっちで面白い動画を作らせようとしたらすぐダメ出しされちゃうんですよね。
そこでダメ元でクソ回答連発のGoogle AIにつくらせてみたら、意外にすんなり作ってくれましたw
もちろん、あからさまなやつは「それは作れません」でアウトなんですが「セーフティフィルタに引っ掛かるからこう書きました」みたいなのは、気にせず行こうぜ!みたいに言えば結構つくってくれますw

つことでANIMA用のまおちーLoraで初期画像を作ってMINIMAXで動かしたやつ。声は調整してないのでまおちーぽくないかもですが。
YoutubeだとダメかもなのでモザイクしてXの方に置いたw
ネックなのは時々それまでの会話が消えちゃって新しい会話に強制移行されることもあるところかなぁ。リロードで回復することもありますけど。
何がきっかけだったか忘れましたが、週末久々にあいうぉのlora学習環境を準備したのでまとめて作ってみました。
ただ学習中はPCでゲームできなくなるんですよねぇ。おかげでブログの更新も忘れちゃいましたし(;^ω^)
学習に使用した画像は3から5枚なので学習時間もそこまでかかっていませんが、それなりにいい感じで描いてくれます。
2026-11-01_AnimaTurbo_00006_
2026-11-02_AnimaTurbo_00019_
2026-11-02_AnimaTurbo_00023_
2026-11-03_AnimaTurbo_00025_
2026-11-03_AnimaTurbo_00003_
2026-11-03_AnimaTurbo_00020_
2026-11-03_AnimaTurbo_00026_
2026-11-03_AnimaTurbo_00009_
2026-11-03_AnimaTurbo_00018_
なぜかみゆきだけは、隙あればロープが描かれるので困ってますがw

MINIMAX H3の感覚を忘れないうちに他のものも作ってみようと思い色々ネタを考えたんですが、

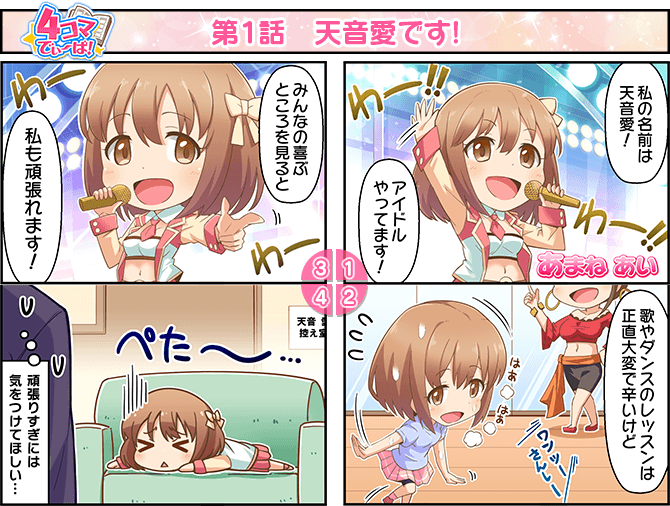
4コマディーバを動かしてみました(゚∀゚)

なんかこれならおまけ動画っぽく作れそうな気もしますしね。
001
今回動かすのは↑記念すべき第一話。やり方はPV作成と同じように、CHATGPTにスタートの絵を描かせて、MINIMAXで動かす。これを4コマ分やる感じですね。
で、できたのがこちら↓

OPとEDも入れてそれっぽくしてみました。4コマではなくなったのでOPタイトルは変えてますw
あと、アニメのミニ劇場っぽく「つづく」って書きましたけど、つづきませんw
そういえば、4コマディーバってマギレポなんかと違って、ゲーム内閲覧だったから今見れるとこないんですよねー。公式ファンクラブのサイトが生きてればまだ公開の望みもあったんですが。みわ子Xで見れる話も一部はあるんですけど(´・ω・`)ザンネンダワァ

MINIMAXが予想以上に使い勝手良かったので、土日を使ってPVっぽいやつを作ってみました(゚∀゚)
最初、I2V用の画像はLoraで作る予定だったんですが、思った以上にポーズの作成に難航して、CHATGPTにプロンプトじゃなく画像をそのまま描かせたら結構いい感じだったので、そのまま採用。そのため多少、誰コレ?( ゚Д゚)、と言うところはあるんですけどね(;^ω^)
動画のプロンプトもCHATGPTにお任せで、正直動画生成にはほとんど手間がかかってません。
ライブの部分は色んなパターンが必要だったんですが、同じようなシーンのプロンプトばかり作るんでここだけ、ちょっと手間かかりましたかね。
音声はライブを除いてMINIMAXが作ったのそのまま使ってます。なので指定外のセリフが結構入ってたりしますけど、声質がよさげなら採用してます。意外とリテイクは少なくてほとんどが1~2回です。
特別編01
寝起きのシーン、レッスンのダンス、めぐ&なっちの会話、ラストのライブ、何度も作ったのはこれくらいですかねー。
今回は複数人を同時に出して動かすってのをめぐ&なっちのところしか使わなかったんですけど、複数人の音声のコントロールは結構大変でした。あそこのバックで流れる星来と愛音の掛け合いだけは別取りで編集時に合成してます。
なんか映画っぽくスタッフロール入れてみましたけど、中身はGoogleAIに適当に作らせたデタラメキャストです。頭のアイドルメンバーのキャストだけ弄ってますがw
 
スタートの画像だけしっかり作ってやれば、その後の動きはほぼ破綻しないし、衣装や顔もしっかり維持。音声も全く違和感なく出来てます。これがローカルPCでできるってのが驚きですね。
これなら頑張れば15分くらいのアニメならできるんじゃない?|д゚)チラッ


新環境Comfy Desktopで早速MINIMAX_H3を試してみることにしました。
と、それに先立ち、PC環境も変更。
前回はRTX3060のPCを使ってたんですが、今度はRTX5070のEasyWan22専用機にComfy Desktopを入れることにしました。こちらもEasyWan22とComfy Desktopが混在できるか心配だったんですけど、特に問題なくインストールできました ε-(´・`) 
では本番、MINIMAX_H3のI2Vを試したいと思います。
動かす画像を今度サビ終になってしまうアンアスを使いたいと思います(´;ω;`)ウゥゥ
スクリーンショット 2026-09-22 152223
シヴァたんです(`・ω・´)
続きを読む

なにやらネット情報でQwen Image 2.1が公開されて、ComfyUIのワークフローに追加されたってのが出てました。

こないだローカル環境寂れてるってブログで書いたばかりなのにね(;^ω^)
早速試してみようとしたんですが、

いや、テンプレートないんだけど( ゚Д゚)

現在使用中の環境は、StabilityMatrixにComfyUI入れたやつなんですけど、コレはもしかして、もうComfy Desktopでしか出さんってことなのか?
他に原因はあるかもしれませんが、良い機会なのでComfyUI Desktopを導入することにしました。
StabilityMatrixを使っている環境に突っ込むのはちょっと心配ではあるんですが、これも経験だ( ゚Д゚)
プログラム自体は公式サイトに行けばすぐ見つかります。

インストールもフォルダ指定くらいで特に設定もほとんどなくほどなく終了。そのまま起動に入るんですが、クラウドとローカルのの選択、スタンドアロンとリモートの選択、初期に導入するテンプレートの選択だけあったかな?環境はローカル、スタンドアローン、テンプレートはMINIMAX_H3を選択しました。MINIMAX_H3はStabilityMatrix環境ではテンプレートに出てこなかったんですよねー。なのでてっきりWEBサービス課金でしか使えないと思ってました。テンプレート更新されてない説が濃厚になってきましたw
選択終了後引き続きなにかのダウンロードが行われますが、なんか初回だけタイムアウトになったんですけど、リブートで問題なく起動できました。
スクリーンショット 2026-09-22 090640
ちょっと、すっきりしてますが見慣れたComfyUIの画面ですね。
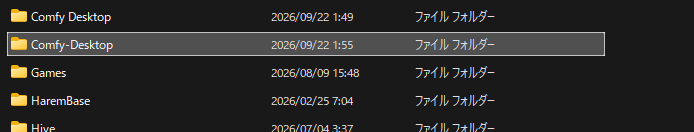
フォルダ構成は
スクリーンショット 2026-09-22 092904
こんな感じで指定したインストール先にそれらしいのが二つできてます。最初、インストール時のタイムアウトのせいでおかしくなったか?と思いましたけど、Comfy-Desktopの方にモデルとか生成結果が入るようになってるみたいです。
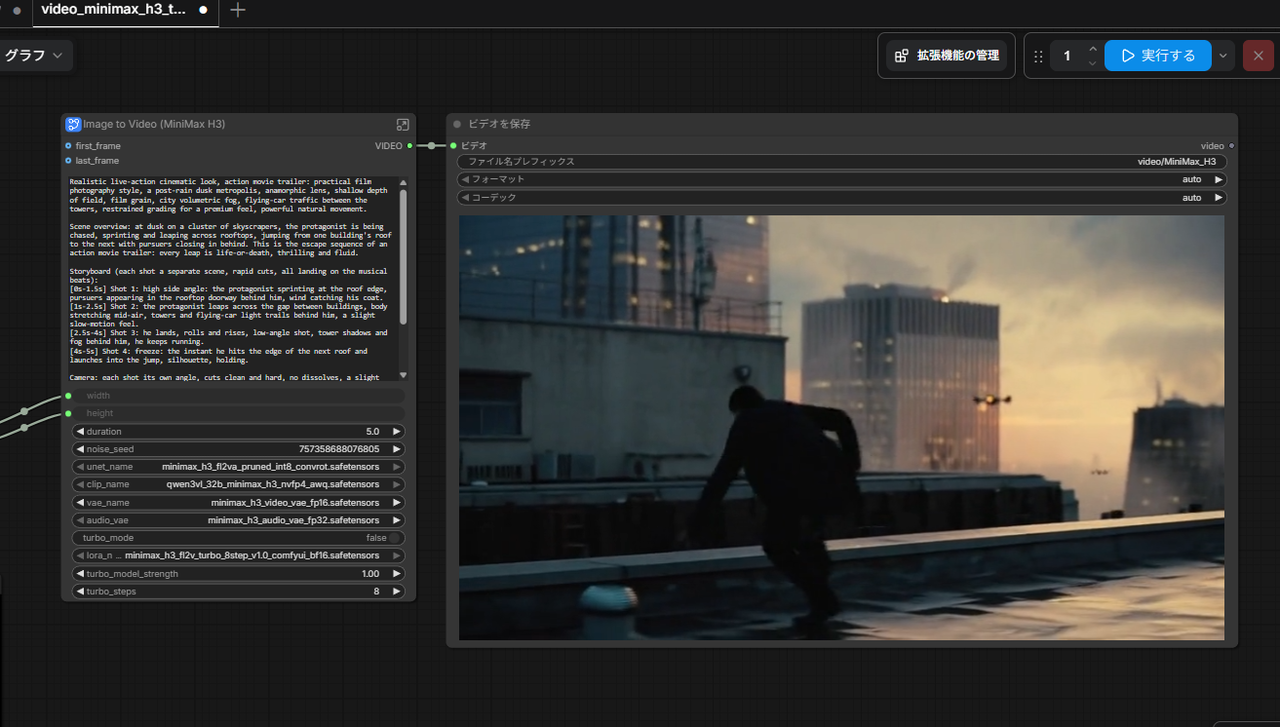
折角テンプレでMINIMAX_H3を入れたのでデフォのまま生成してみます。
スクリーンショット 2026-09-22 092454
5秒程度の動画で10分弱、ちょっと時間はかかりますがむっちゃ違和感なく動きますねー。I2V版もあるので早速試したいんですがそれは別の機会に。
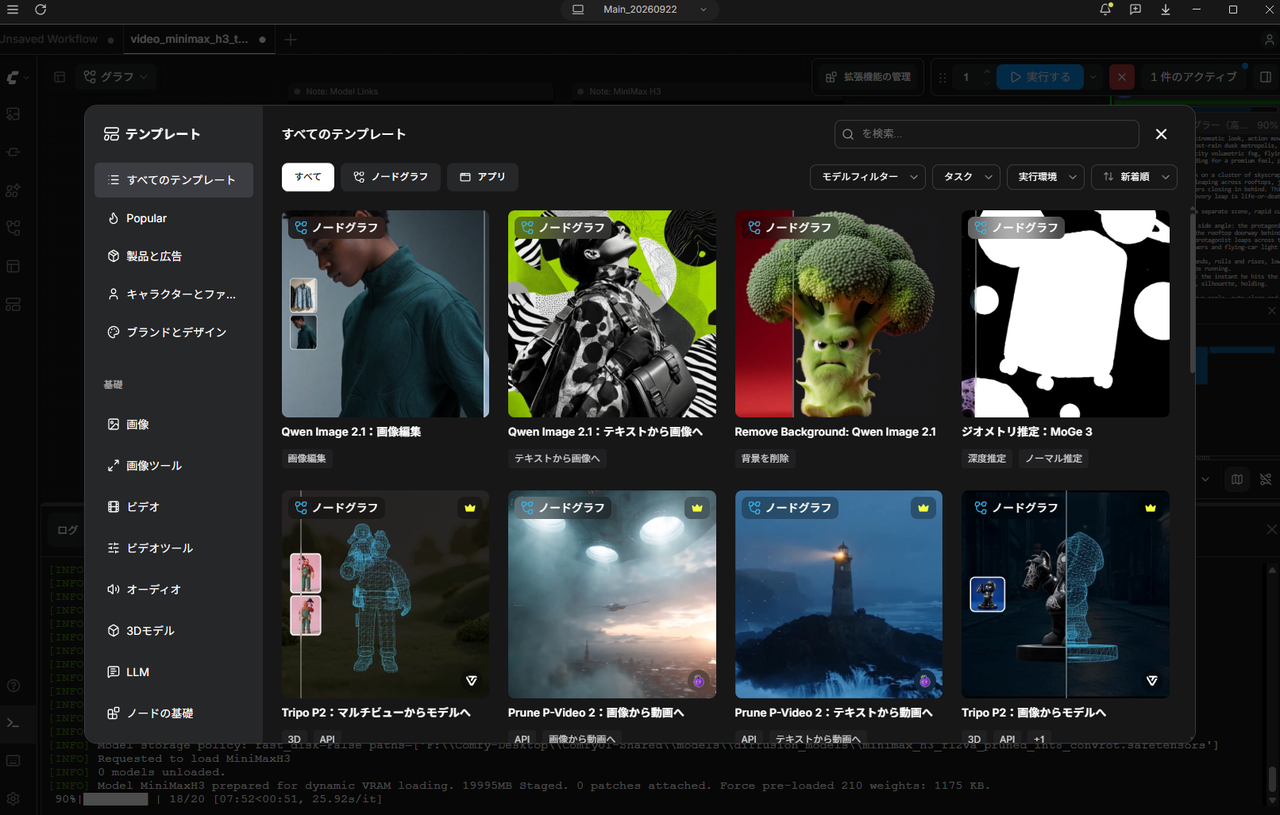
動作確認はできたので早速テンプレートをチェックしてみますが、
スクリーンショット 2026-09-22 092147
Qwen Image 2.1あるやん!( ゚Д゚)
スクリーンショット 2026-09-22 092050
ちなみにこちらが旧環境。
なるほど、ローカル環境が廃れたわけじゃなくて情報が入ってこなかっただけか(´・ω・`)
まぁ、CIVIATIとかは分割後廃れた気はしますけどね(;^ω^)
念のため、その後StabilityMatrixの方も動かしてみましたが、特に問題は出てないようです(゚∀゚)ヨカッタ
StabilityMatrix環境との同時起動も可能ですね。

さて、色々やりたいこと増えたなぁw連休もう残ってないけどww

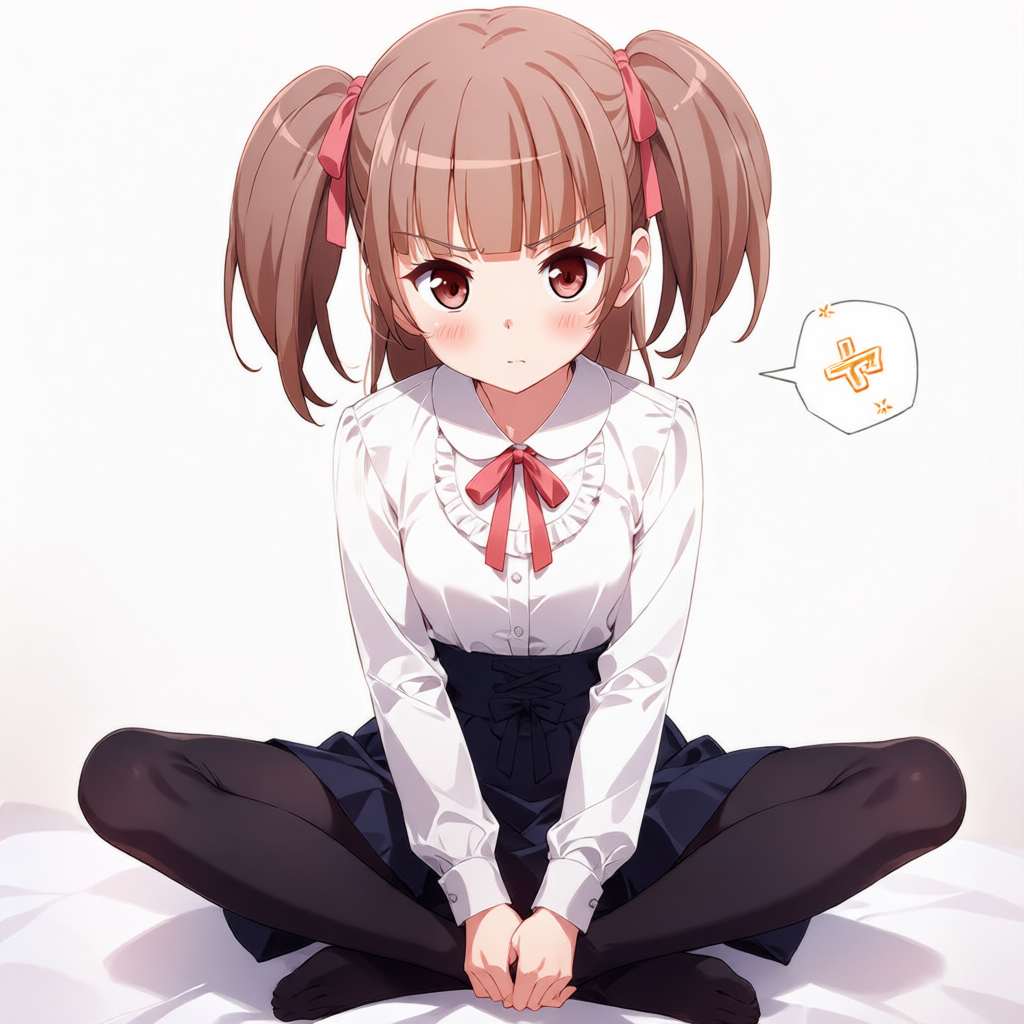
さて、こないだ入れたAnimaモデル。サクサク快適なのですけど、こんだけ軽いと自分の好きなキャラとか描きたくなったりします。ですが残念ながら入ってないんですよ!アイうぉが( ゚Д゚)
2026-09-20_AnimaTurbo_00011_
で、ネットを調べてみるとsd-scriptsがAnimaモデルのLora学習に対応してるとのことなので、超久々に作ってみることにしました(゚∀゚)
既にStabilityMatrixに入れていたKohya-ssをアップデート。バージョンが26になりました。
スクリーンショット 2026-09-20 154939
sd-scriptsが対応していても、Kohya-ssが対応してるかわからないので一応Aboutを見てみますが、
スクリーンショット 2026-09-20 155424
ちゃんと対応してるみたいですね。 
続きを読む

折角の連休なので普段時間なくてやれないことをと考えたら、最近AI触ってないことを思い出したのでちょっと最近の情勢を調べてみたんですが、

ローカル環境むっちゃ寂れてない?( ゚Д゚)

ComfyUIのテンプレも全然更新されてないし、CiVITAIもなんかパッとしない感じ。AI規制関係で色々厳しいようなことをGoogleAIは言ってましたけど、コイツあてにならないんだよなw
ComfyUIはいつの間にか単独環境になってたらしいのでそのうち試したいと思うんですけど、今の環境壊れると困るので新しいPC買わないとなんですよねぇ。とはいえ今はPC高いのでちょっと手が出せないのでどれか一台整理して空き作るかなぁ。
一応、グラウドサービスのもやってみたんですけど、なんか規制に引っかかって画像作れなかったのにしっかりクレジット減ってる(※画面には作れなかったので減ってないと書いてる)っていう現象に遭遇したので、やはりローカルしかないわーと思うのでしたw
で、動画は相変わらずLTX2.3ばかりなので、久々に静止画の方のモデルを見てみたら、Animaなるものがありました。もう名前からして版権アニメ絵をガンガンかけそうな感じなんですけど、Anima_pencilとかAnimagineとは何の関係もない模様なので、ちょっと試してみました。

Turboモデルが早いらしいので、CIVITAIからダウンロード。
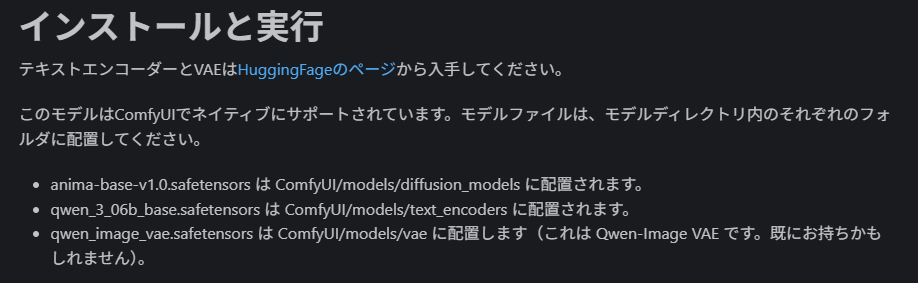
他に必要なのはテキストエンコーダにqwen_3_06b_base.safetensors、VAEにqwen_image_vae.safetensorsが必要なので公式のHugging Faceからダウンロードしてそれぞれの場所に置いておきます。
スクリーンショット 2026-09-20 115055
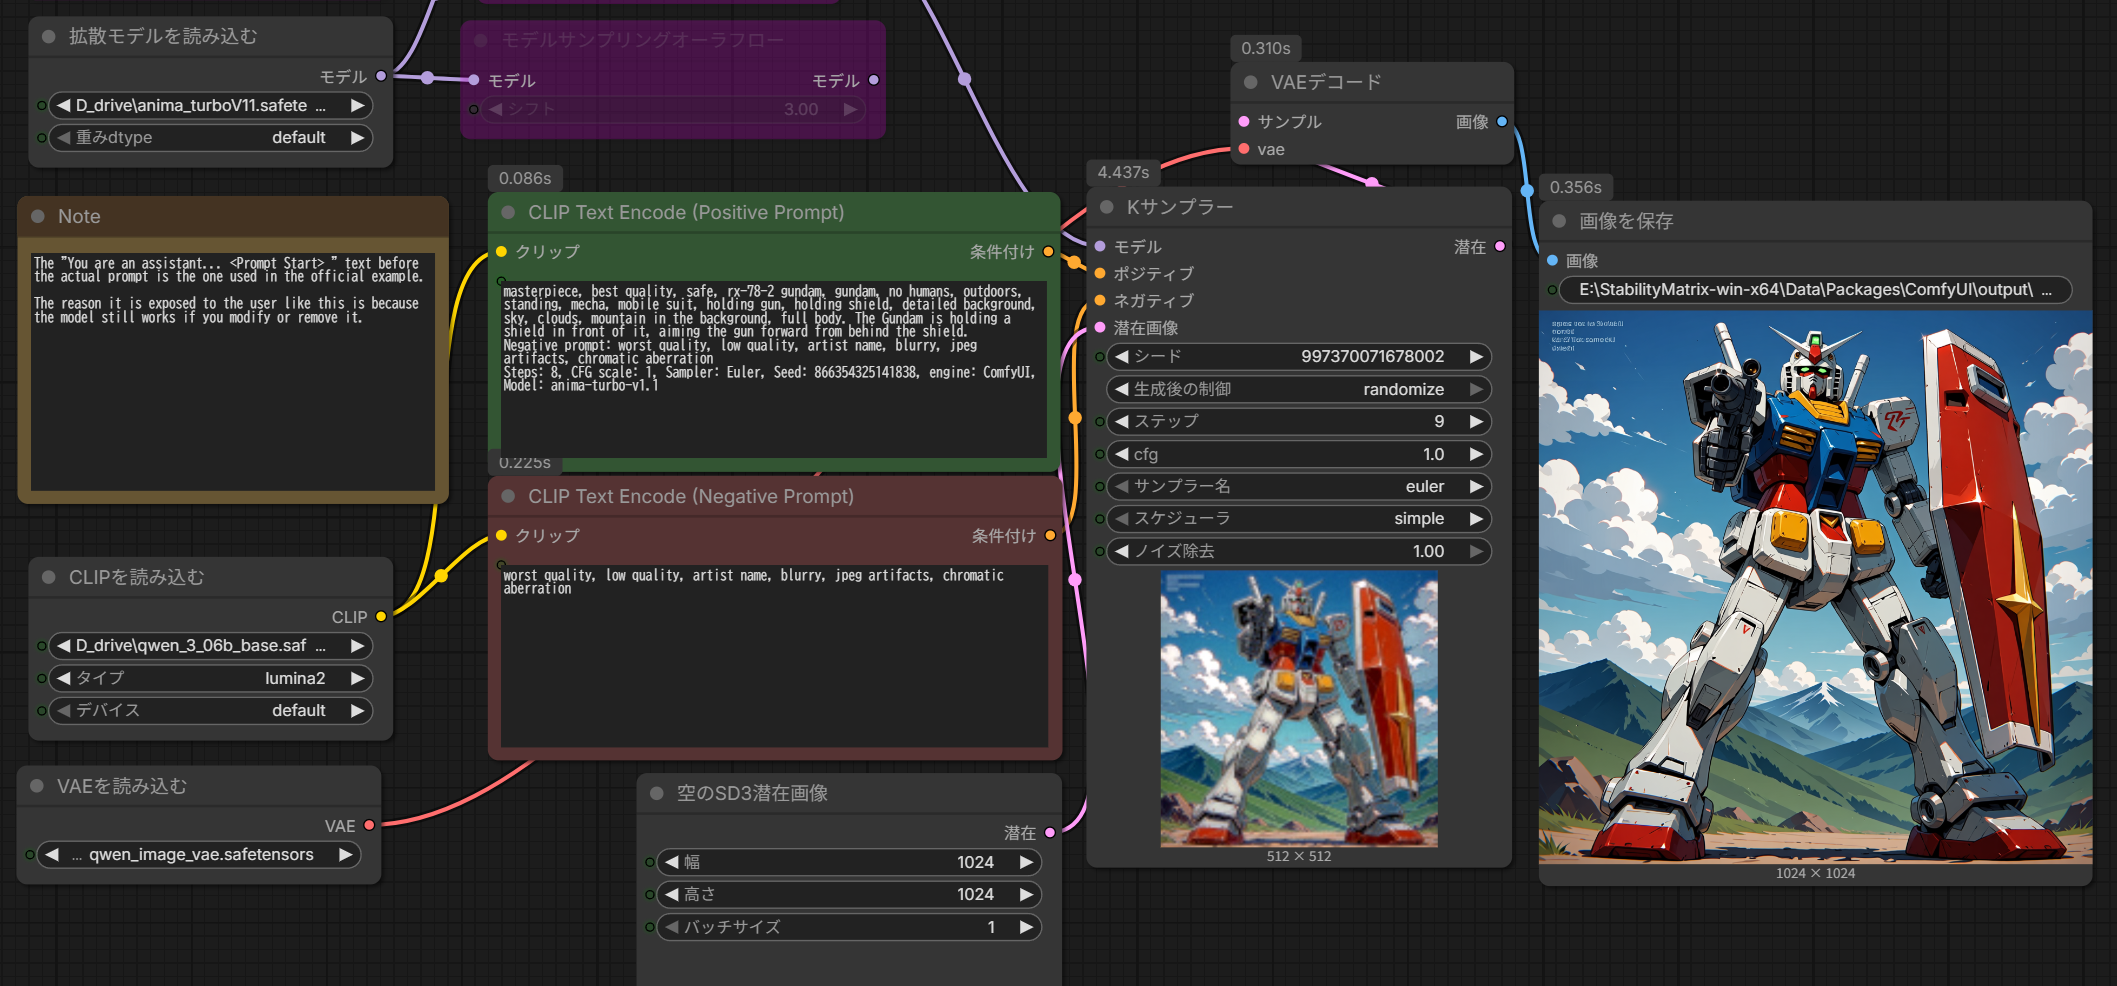
ワークフローは置いてなかったので、Z-Image-Turboで使ってたのを使いまわし。
(※後で気づきましたが公式のHugging Faceにはworkflowがあったようです(;^ω^))
スクリーンショット 2026-09-20 115950
むっちゃ早いですね( ゚Д゚)
ボタンポチして5秒くらい。
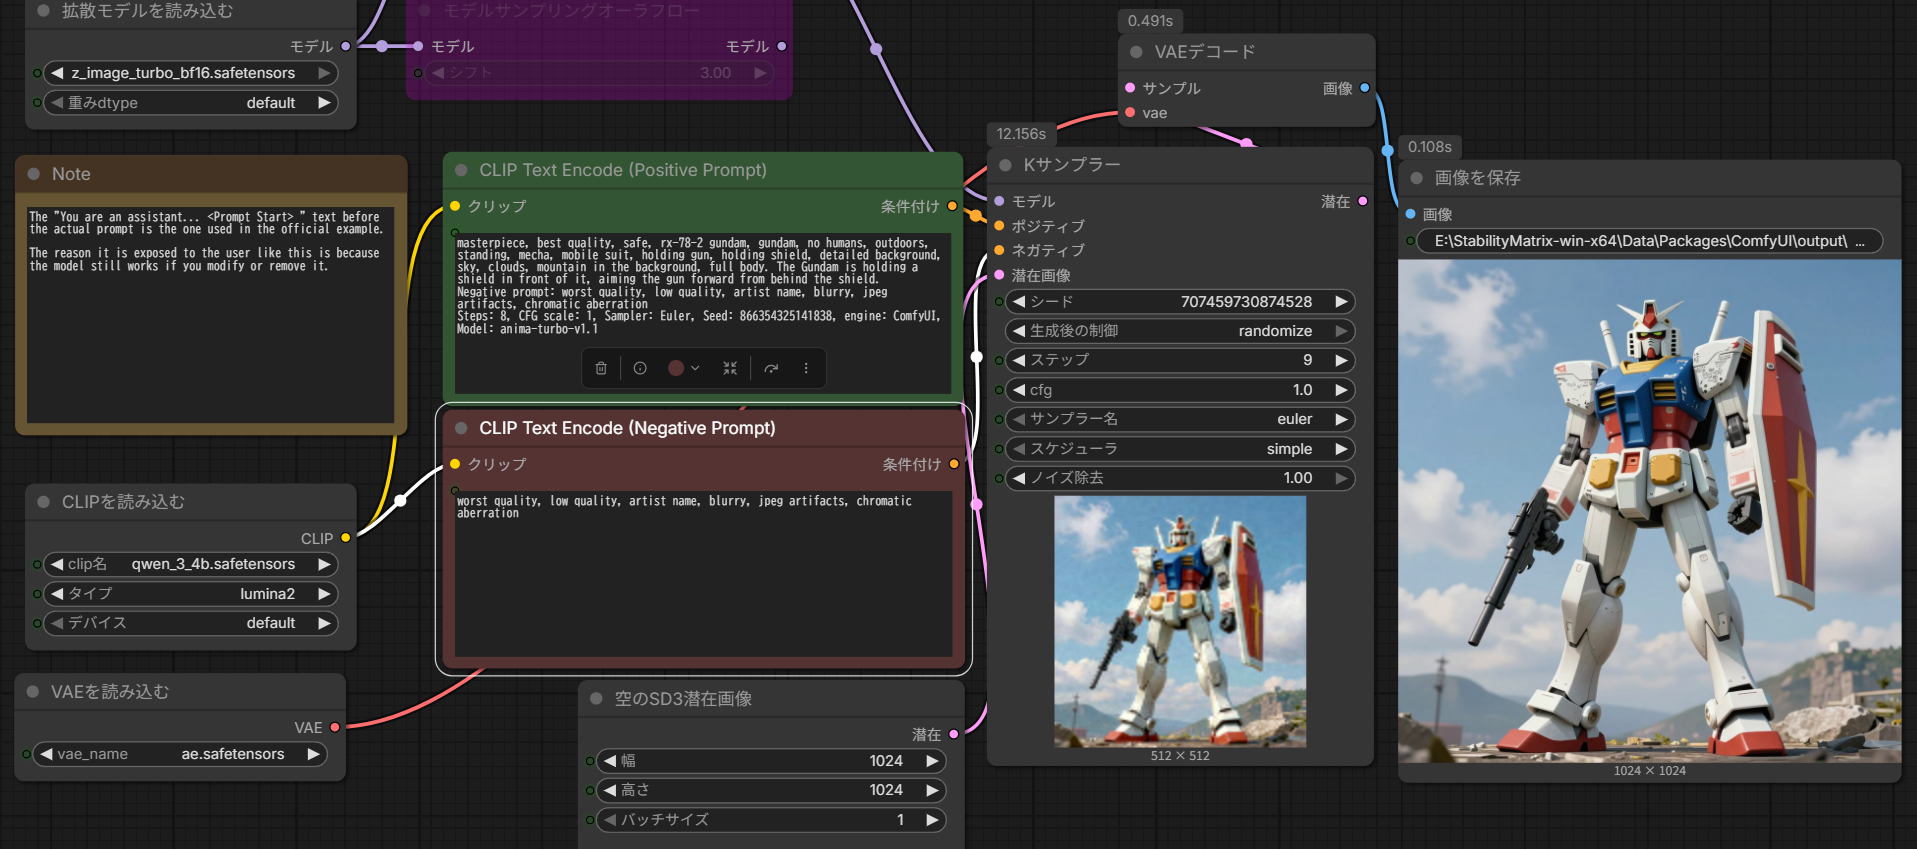
スクリーンショット 2026-09-20 120556
こちらはZ-Image-Turbo。同じプロンプトで12秒です。
モデルのサイズもAnimaはZ-Image-Turboの1/3くらいなので、モデル切り替えも早いんですよね。
まぁ、同じプロンプトでも絵の感じは全然違うんですけど。
2026-09-20_ZIT_00015_
↑Anima
2026-09-20_ZIT_00016_
↑ZIT

タイトルどおりなんですが結果から言うと失敗でした(´・ω・`)
なんというか、メディアだとよかったのに、生放送で聴いたら微妙だった、みたいなw
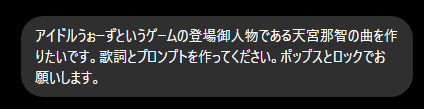
そもそものきっかけは、曲作りを依頼されたことに始まるのですが、わたし自身音楽についての知見はありませんのでもらった歌詞をAIに放り込んでできた曲を依頼元に渡しただけなんですが、むっちゃ微妙な曲だったにも関わらず、何回か聞いてると意外にふと口ずさむくらいの感じになってましたw
で、

これはなんか使えるんじゃね?

ということで早速GPTに依頼。
a2a41bcb84f62b40cc706c55687024cb
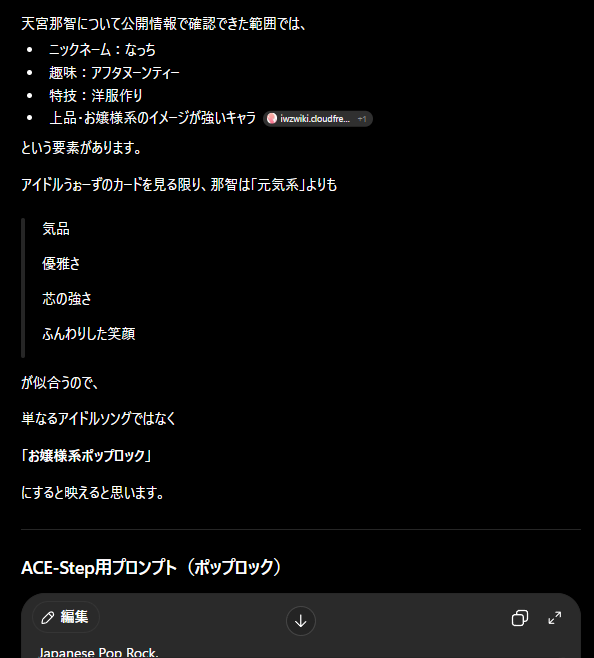
むちゃぶりにも関わらず作ってくれましたよw
c317101828013a17a34845e174a5bbf3
早速、もらったプロンプトと歌詞を使って、ACE-STEPで生成してみました(゚∀゚)
できたやつ
とりあえずそれっぽいのができたのですが、当然これはなっちの声ではありませんので、DEEP EXTRACTでボーカルと曲に分離。ボーカルの方をAI変換でなっちの声にするという寸法です。
今はDEEP EXTRACTはバージョン2があるようなんですけど、ConfyUI Managerでは1しかなかったので1でやってます。
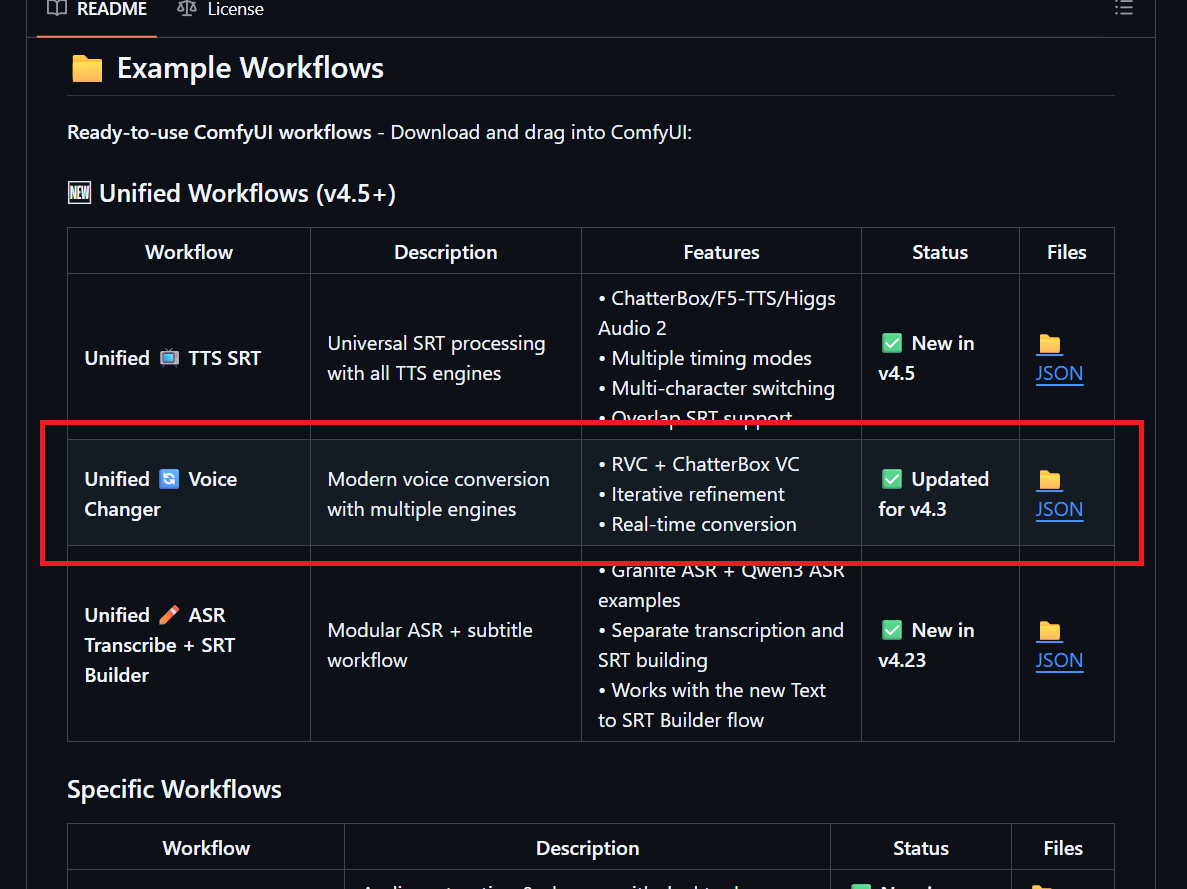
ボ-カル変換で採用したのはTTS-Audio-SuiteのChatterbox。実はかなり前に使ったことがあるんですが、当時は日本語はダメダメでした(´・ω・`)
366bc568f7bc8b10b4c8018ce5b0d69d
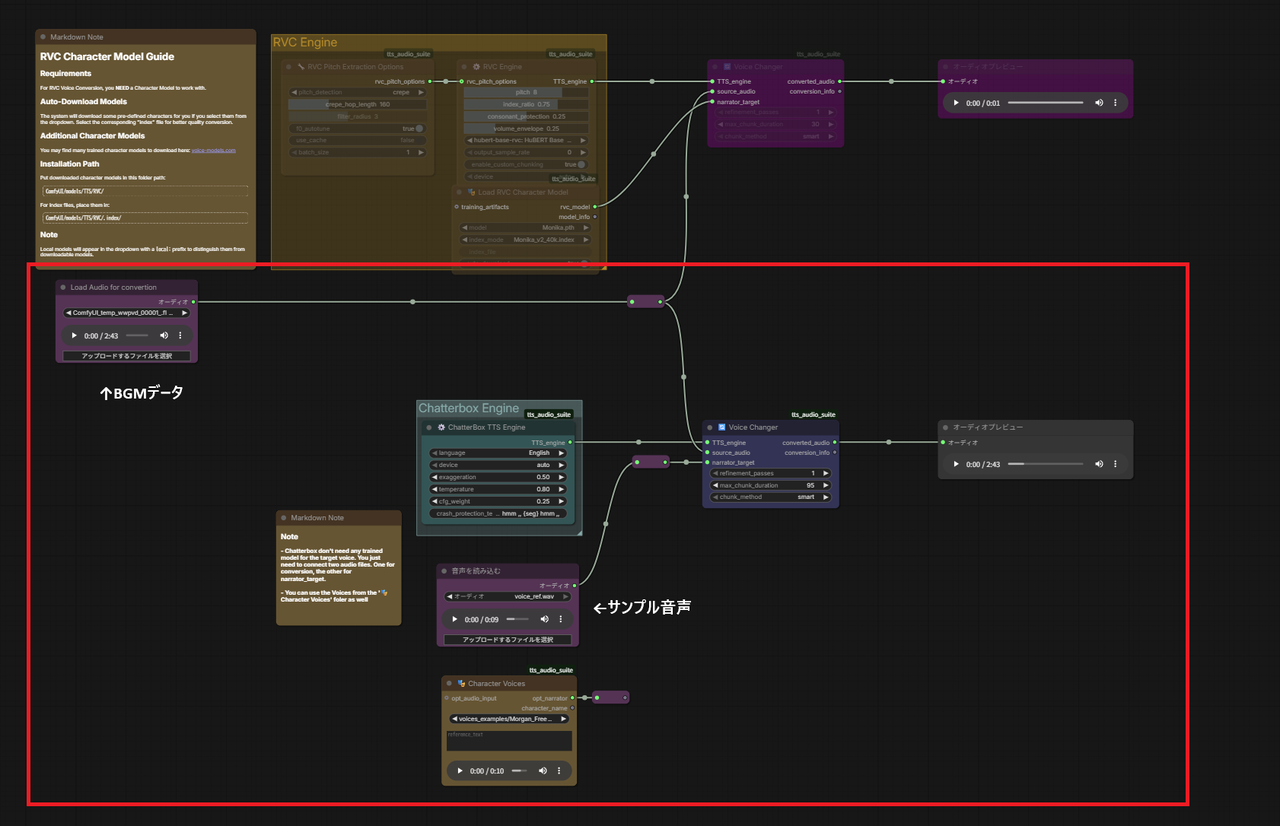
ワークフローは赤枠のやつを使用。あ、言い忘れましたがこちらもConfyUI用です。
ee97a81dbd03cd1f760d2c762c321afd
上側は学習データがいるっぽいので下側(赤枠のところ)だけ使います。
画像ではBGMって書いちゃってますが、分離したボーカルデータをそこに入れてます。サンプル音声のところになっちの声ですね。
で、結果(´・ω・`)グエー
思わずリラックス!リラックス!って言いたくなる音声ですw
もしかしたらエコーとか掛けたら使えるようになるのかもしれませんが、そもそもコレ聴いてなっちだ!(゚∀゚)とはなりませんね。
ちなみに、Chatterboxの設定にJapaneseがあるんですが、選択しても未対応でエラーがでるので、変換はenglishでやってます。
もう少しパラメーター弄ってみようと思いますがまぁ厳しいだろうなぁ(´・ω・`)


Irodori-TTSのV3が出たということで、試さなきゃーと思いつつ先送りになっていたのですが、ようやく時間ができたので導入です(゚∀゚)
V2の方はインストール時の記録がなくてどうやって導入したのがさっぱり覚えていないので、今回はちゃんとメモっておきますw

続きを読む

↑このページのトップヘ